Travailler avec les agents IA
Un cadre pratique pour le déploiement de l’IA en entreprise
Dans l’article n° 001, nous avons abordé l’essor de l’IA agentique et la transition d’une assistance basée sur des prompts vers des agents capables de poursuivre des objectifs spécifiques. L’article n° 002 était consacré à l’IA hybride et aux raisons justifiant l’affectation de différentes charges de travail à des environnements informatiques adaptés. L’article n° 003 explorait la manière dont les organisations peuvent évaluer la véritable valeur métier de l’IA agentique, au-delà de la simple productivité.
L’article n° 004 aborde la question pratique qui en découle : comment les entreprises, qu’il s’agisse de professionnels indépendants, de petites équipes ou de grandes organisations, peuvent-elles mettre les agents IA à contribution de manière responsable, abordable et efficace ?
Résumé
Les agents IA sont en train de passer du stade de simples démonstrations à celui d’une assistance significative dans le travail quotidien. Cependant, un déploiement réussi ne se résume pas à installer un modèle, à lancer un chatbot ou à connecter un agent à chaque application. Il commence par un workflow métier bien défini, un objectif clair, un accès approprié aux outils et aux informations, ainsi qu’une méthode fiable pour mesurer les résultats.
Dans une petite entreprise, un agent IA peut trier les demandes des clients, rédiger des réponses ou suivre les mises à jour des fournisseurs. Dans les grandes organisations, les agents peuvent aider à la révision de documents, à la recherche d’informations, aux opérations de service et au reporting intersystèmes. Dans tous les cas de figure, la valeur de l’agent dépend moins de son autonomie perçue que de la fiabilité des tâches qu’il accomplit.
Ce guide présente un modèle de déploiement pratique qui distingue cinq décisions clés : quel workflow améliorer, de quelles informations et de quels outils l’agent a-t-il besoin, où la charge de travail doit-elle être traitée, comment maintenir le contrôle humain, et comment mesurer et faire évoluer un projet pilote réussi. Il clarifie également des concepts techniques essentiels, notamment les modèles, la génération augmentée par récupération (RAG), l’appel d’outils, l’orchestration et l’exécution locale, dans le cloud ou hybride, sans partir du principe que chaque entreprise a besoin d’une équipe d’ingénierie IA dédiée.
L’objectif n’est pas d’automatiser complètement chaque workflow, mais de déterminer le niveau approprié d’assistance, d’automatisation et de supervision pour chaque tâche, et de démontrer que les résultats justifient l’investissement.
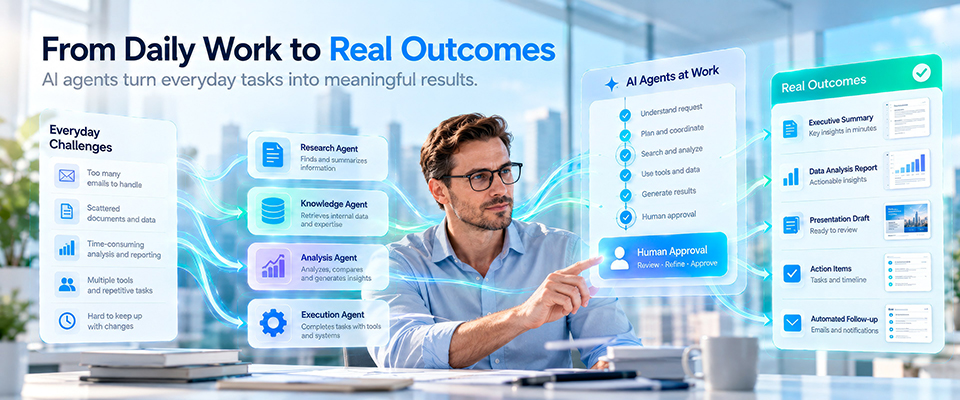
Points clés à retenir
- Commencez par un workflow, pas par un modèle. Choisissez un problème récurrent avec des entrées claires, des résultats mesurables et un responsable identifiable.
- Un agent est un système, pas simplement un LLM. Un déploiement efficace combine raisonnement, connaissances, outils, autorisations, surveillance et supervision humaine.
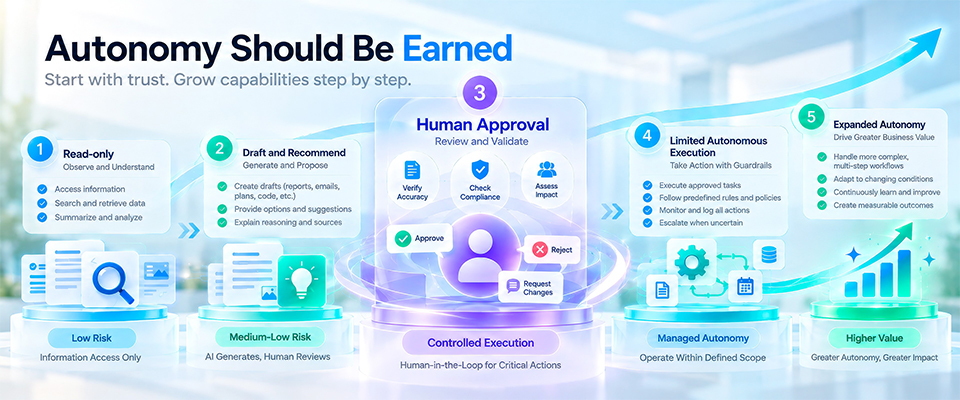
- L’autonomie doit se mériter. Commencez par des actions en lecture seule et des actions « brouillon », puis n’étendez les autorisations qu’une fois la fiabilité démontrée.
- Le choix entre une IA locale, dans le cloud ou hybride relève de décisions liées à la charge de travail. La sensibilité des données, la latence, la connectivité, les capacités du modèle, le coût d’exploitation et la maintenance sont autant de facteurs importants.
- Évaluez les résultats, pas les démonstrations. Mesurez la qualité d’exécution, le taux d’intervention, le temps écoulé, les coûts d’exploitation et l’impact métier.
- Concevez en prévision du changement. Les modèles, les outils, les réglementations et les exigences métier évoluent ; le succès du déploiement d’agents nécessite une évaluation continue et une appropriation du projet.
De l’assistant IA à l’agent IA
La différence réside dans la responsabilité du workflow
Un assistant IA aide généralement les utilisateurs à accomplir une partie d’une tâche, par exemple en résumant un document, en suggérant une réponse ou en expliquant une feuille de calcul. En revanche, un agent IA peut se voir attribuer des objectifs spécifiques et effectuer plusieurs étapes pour atteindre ces objectifs dans des limites définies. Un agent IA peut récupérer des informations pertinentes, décider quels outils approuvés utiliser, vérifier les résultats, puis soit renvoyer un résultat, soit demander l’approbation d’un humain.
Cela ne signifie pas que les agents soient systématiquement plus adaptés que les assistants. Un simple assistant de rédaction peut s’avérer plus sûr, moins coûteux et plus facile à utiliser qu’un processus autonome. La bonne question est la suivante : quelles étapes tirent véritablement profit d’une exécution déléguée, et lesquelles nécessitent encore l’intervention d’une personne ?
Voici un spectre pratique : Assister → Recommander → Exécuter avec validation → Exécuter dans des limites → Surveiller et Remonter. Les organisations doivent choisir le niveau d’autonomie le plus bas qui réponde de manière fiable aux besoins de l’entreprise.
L’IA génère-t-elle une valeur commerciale mesurable ?
Un exemple concret : le traitement des demandes des clients
Prenons le cas d’un client qui pose une question sur la compatibilité d’un produit. Un assistant IA peut aider un employé à rédiger une réponse. Un agent IA aux capacités limitées peut classer la demande, extraire les informations approuvées sur les produits, préparer une réponse adaptée et signaler toute incertitude. Avec une autorisation explicite, un agent plus avancé pourrait créer un ticket de service ou mettre à jour le dossier d’un client. Cependant, ces dernières étapes introduisent des risques supplémentaires, car l’agent modifie un système d’entreprise ou communique avec l’extérieur.
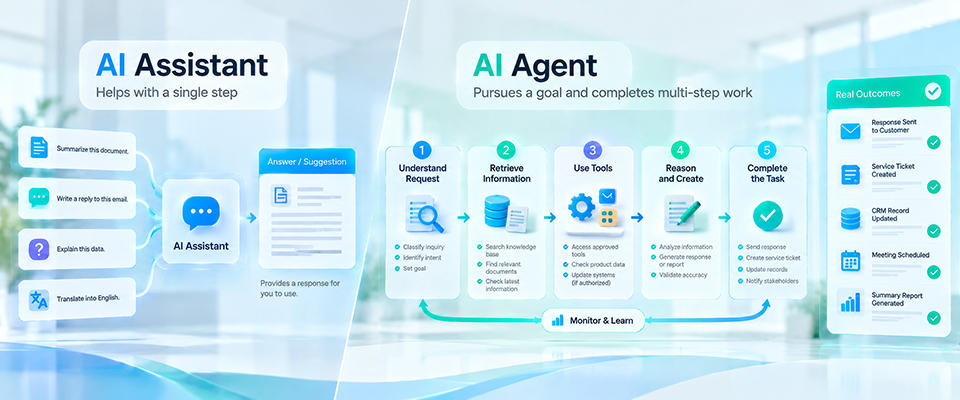
La distinction est importante : une réponse réussie ne prouve pas qu’un agent est capable d’envoyer des messages, de modifier des dossiers ou de prendre des engagements en toute sécurité. Chaque action supplémentaire nécessite ses propres contrôles et tests.
Commencez par le workflow, pas par la technologie
Choisissez un premier cas d’utilisation mesurable
Le projet pilote le plus efficace n’est souvent pas la démonstration la plus spectaculaire, mais plutôt un workflow caractérisé par une répétition régulière, des règles établies, des informations facilement accessibles et une définition claire de la réussite. Parmi les candidats idéaux, on peut citer les recherches de connaissances en interne, la classification récurrente de documents, la rédaction de premières ébauches de rapports, la préparation du suivi des réunions, le triage des demandes d’assistance et le suivi des modifications apportées aux sources d’informations approuvées.
Évitez de démarrer avec un workflow nécessitant un accès illimité, des actions irréversibles, une responsabilité ambiguë ou des décisions à enjeux élevés. Pour les processus susceptibles d’avoir un impact significatif sur la sécurité, les droits légaux, les finances ou les relations clients, il est essentiel de privilégier la vérification humaine et d’impliquer des experts qualifiés dans le domaine.
Toutes les tâches répétitives ne constituent pas de bons projets initiaux pour l’automatisation. Les candidats appropriés présentent un déclencheur clair, des critères d’achèvement définis, des informations accessibles et une personne désignée chargée de gérer les exceptions. De plus, la tâche doit se produire suffisamment souvent pour fournir des informations utiles pendant la phase pilote. En revanche, les processus qui changent fréquemment, qui reposent sur un jugement non documenté ou qui nécessitent des décisions irréversibles peuvent tirer profit d’un assistant IA intégrant une supervision humaine.
Avant de hiérarchiser un workflow, posez-vous quatre questions pratiques : les données d’entrée sont-elles suffisamment structurées ? La réussite peut-elle être vérifiée de manière indépendante ? L’agent peut-il s’interrompre en toute sécurité et demander de l’aide ? Et cette amélioration aura-t-elle un impact positif sur les clients, les employés, ou sur les résultats de l’entreprise ? Un processus à fort volume et à la complexité maîtrisable constitue souvent un meilleur point de départ qu’un projet autonome ambitieux dont les résultats sont difficiles à évaluer.
Par exemple, un petit distributeur pourrait commencer par classer les demandes de renseignements sur les produits et rédiger des réponses à l’aide de la documentation produit approuvée. Le projet pilote ne doit pas débuter par la prise en charge automatique des prix, des stocks ou des dates de livraison. Ces actions ne peuvent être introduites qu’après que l’organisation a testé l’exactitude des données sources, la gestion des exceptions et les règles d’approbation.
Une fiche d’évaluation simple pour le projet pilote
- Besoin métier : quel problème ou quel retard ce workflow engendre-t-il aujourd’hui ?
- Fréquence et référence : à quelle fréquence cela se produit-il, et quel en est actuellement le coût en termes de temps, de qualité ou de retouches ?
- Préparation des informations : les documents sources sont-ils exacts, à jour et autorisés à l’usage ?
- Limites de l’action : l’agent peut-il commencer par lire et rédiger plutôt que de modifier les systèmes ?
- Critères de réussite : quels sont les niveaux minimaux acceptables en matière de précision, de délais d’exécution et de gestion des escalades ?
- Responsabilité : qui approuve les accès, examine les échecs et décide de la poursuite du projet ?
Un workflow restreint et mesurable peut générer un apprentissage plus fiable qu’un agent ambitieux qui tente d’effectuer le travail de tout un service dès le premier jour.
Les éléments constitutifs d’un agent IA opérationnel
Modèles, connaissances, outils et orchestration
Un grand modèle de langage (LLM) interprète les instructions et génère du texte ou des sorties structurées. Il s’agit d’un composant important, mais il ne fournit pas à lui seul une connaissance fiable des dernières politiques de l’entreprise ni l’autorisation d’interagir avec les systèmes métier.
La génération augmentée par récupération (RAG) permet à une application d’extraire du contenu pertinent à partir d’une source de connaissances approuvée et de le fournir comme contexte à un modèle. Un système RAG bien conçu nécessite des autorisations d’accès aux documents, un indexage, des contrôles d’actualité et un moyen de citer ou de retracer les sources. La recherche peut réduire le nombre de réponses non fondées, mais elle ne garantit pas l’exactitude.
L’appel d’outils permet à un agent de demander une fonction spécifique, telle que la recherche dans un catalogue, la lecture d’un dossier autorisé, la création d’un brouillon de ticket ou l’interrogation d’une base de données. L’accès aux outils doit être strictement délimité, authentifié, consigné et segmenté en fonction du risque. Le modèle ne doit pas être considéré comme un substitut à l’autorisation au niveau de l’application.
L’orchestration coordonne la séquence des étapes, l’exécution des outils, les nouvelles tentatives, les délais d’attente et la remontée vers un niveau supérieur. Elle peut également répartir le travail entre des agents spécialisés. Le fait d’avoir plusieurs agents n’est pas automatiquement préférable : les transferts supplémentaires peuvent accroître la latence, le coût, la complexité et les modes de défaillance. Un agent unique disposant de quelques outils fiables constitue souvent le meilleur point de départ.
Le modèle linguistique fournit des capacités de raisonnement et de langage, mais il ne constitue pas l’agent dans son intégralité. La génération augmentée par récupération (RAG) peut fournir des extraits pertinents provenant de sources de connaissances approuvées au moment d’une requête. L’appel d’outils permet à l’agent de demander une action à une interface d’application définie. Une couche d’orchestration détermine quelles étapes sont autorisées, dans quel ordre, et dans quelles conditions le workflow doit s’arrêter ou restituer le contrôle à une personne.
La mémoire doit également faire l’objet d’une définition rigoureuse. La mémoire contextuelle à court terme aide un agent à suivre une tâche à travers plusieurs étapes. La mémoire persistante peut conserver certaines préférences ou l’état du workflow d’une session à l’autre. Aucune de ces deux mémoires ne doit être considérée comme une archive illimitée d’informations confidentielles. Les entreprises doivent préciser ce qui est stocké, pendant combien de temps, qui peut y accéder, et comment les informations erronées ou obsolètes sont corrigées.
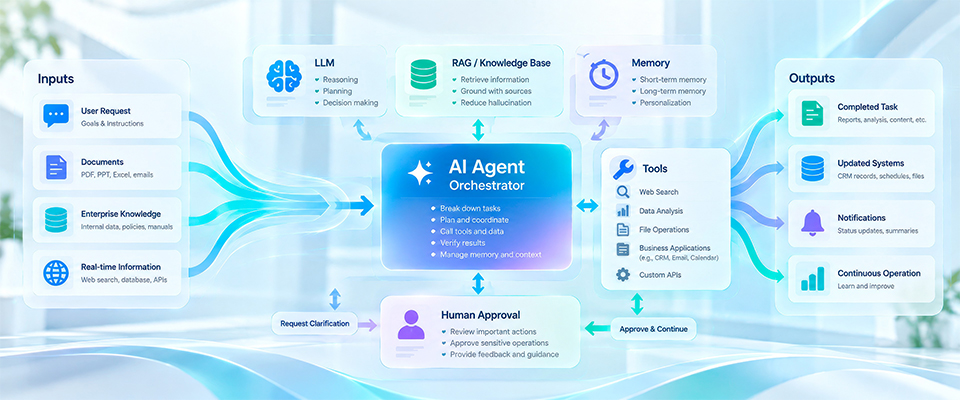
Un workflow de référence
Demande métier → Validation du périmètre → Récupération des connaissances approuvées → Planification ou sélection d’une action → Appel de l’outil autorisé → Vérification du résultat → Approbation humaine si nécessaire → Enregistrement du résultat
Ce workflow est conçu pour être modulaire, ce qui permet à une entreprise de remplacer le modèle, le référentiel de connaissances ou l’environnement d’exécution sans avoir à redéfinir ses objectifs. Cette modularité facilite également l’identification des erreurs : les informations étaient-elles obsolètes ? Le modèle a-t-il mal interprété la demande ? Un outil a-t-il échoué ? Une approbation nécessaire faisait-elle défaut ?
Prenons l’exemple d’une demande client entrante qui demande si un produit répond à une exigence spécifique. Tout d’abord, l’agent classe la demande et extrait les passages pertinents de la base de connaissances produit approuvée. Ensuite, il vérifie si les informations citées sont à jour et si la réponse nécessite des données provenant d’un autre système, tel que la gestion des stocks ou l’éligibilité au service. L’agent rédige alors une réponse accompagnée d’éléments justificatifs. Si une caractéristique n’est pas claire, s’il manque une source ou si un engagement commercial est nécessaire, la demande est transmise à un collaborateur désigné.
Une fois l’approbation obtenue, la réponse peut être envoyée via un outil de communication autorisé. Le workflow enregistre également ses sources, les actions effectuées, les horodatages et toute intervention humaine. Cela permet à l’organisation de mesurer des indicateurs clés tels que le délai de traitement, l’exactitude des faits, le taux d’escalade et la satisfaction client. Cet exemple illustre pourquoi un agent est bien plus qu’un simple chatbot : il coordonne une séquence d’actions définies tout en respectant des limites claires quant à ce qu’il peut décider de manière autonome.
Où l’agent IA doit-il fonctionner ?
IA locale, IA dans le cloud et IA hybride
L’article n°002 a établi que le déploiement de l’IA devait donner la priorité aux charges de travail. Le même principe s’applique aux agents. Un agent peut utiliser un modèle local, un modèle hébergé dans le cloud ou une combinaison des deux. Le choix approprié dépend de divers facteurs, notamment la sensibilité des informations, les exigences du modèle, la connectivité, la réactivité, les coûts d’exploitation et la capacité de maintenance du système.
L’IA locale permet de conserver certaines données et inférences au sein d’un appareil ou d’un environnement géré, prend en charge certains workflows hors ligne et offre des dépenses d’infrastructure par utilisation plus prévisibles une fois la capacité disponible. Cependant, le fonctionnement local nécessite toujours des contrôles de sécurité, des mises à jour, une mémoire et une puissance de calcul suffisantes, ainsi qu’un support opérationnel. « Local » ne signifie pas automatiquement « privé » ou « conforme ».
L’IA dans le cloud peut offrir un accès à des modèles puissants, une capacité élastique, des services gérés et une expérimentation rapide. Les compromis peuvent inclure des coûts d’utilisation récurrents, une dépendance au réseau, des considérations relatives au traitement des données et la disponibilité des services. La latence réelle dépend du modèle, du réseau, de la charge de travail et de la mise en œuvre. Le cloud n’est pas intrinsèquement plus lent.
L’IA hybride achemine différentes tâches vers l’environnement le plus approprié. Une composante locale peut classer des informations ou récupérer des documents approuvés, tandis qu’un service cloud gère une étape de raisonnement exigeante dans le cadre d’une politique de données approuvée. Un autre workflow peut s’exécuter entièrement en local ou entièrement dans le cloud. L’objectif n’est pas de maximiser la complexité architecturale, mais d’adapter la charge de travail aux besoins métier.
L’exécution locale peut s’avérer particulièrement avantageuse lorsque des informations sensibles doivent rester dans un environnement contrôlé, que l’accès au réseau est peu fiable ou qu’une charge de travail prévisible bénéficie de ressources informatiques dédiées. Cependant, l’exécution d’un modèle en local ne garantit pas automatiquement que l’ensemble du workflow reste privé, les recherches externes, les communications par e-mail, la télémétrie, les mises à jour et les outils connectés peuvent toujours transférer des données en dehors de l’appareil ou du réseau. La sécurité dépend de l’ensemble du cheminement des données.
L’IA dans le cloud offre un accès à des modèles plus volumineux ou fréquemment mis à jour, ainsi qu’à des services gérés, sans nécessiter le même niveau de maintenance de l’infrastructure locale. En contrepartie, les entreprises doivent évaluer les pratiques de traitement des données, les conditions de service, les coûts récurrents, les problèmes de connectivité et l’impact opérationnel d’éventuelles pannes chez les fournisseurs. Les architectures hybrides permettent d’orienter différents processus vers différents environnements, par exemple, récupérer localement des documents internes tout en recourant au raisonnement basé sur le cloud pour une entrée approuvée et réduite au minimum.
La décision de placement doit être prise en fonction de la charge de travail plutôt que de la marque ou du modèle. Comparez les exigences de qualité, les objectifs de temps de réponse, le volume prévu, le coût total de possession, les compétences informatiques disponibles, les besoins en matière de résidence des données et la reprise après sinistre. Une charge de travail qui semble peu coûteuse lors d’une courte démonstration peut s’avérer onéreuse à grande échelle. De même, l’infrastructure locale peut être sous-utilisée si l’usage est sporadique.
Liste de contrôle pratique pour le placement des charges de travail
- Données : quelles informations quittent l’appareil, les locaux ou l’environnement contrôlé ?
- Capacités : le modèle sélectionné gère-t-il de manière fiable les exigences en matière de langage, de contexte et de raisonnement ?
- Performances : quels temps de réponse et quel débit le workflow requiert-il ?
- Disponibilité : que se passe-t-il lorsque le réseau ou le service du modèle n’est pas disponible ?
- Aspects économiques : quels sont les coûts totaux liés au matériel, à l’inférence, à l’intégration, à l’administration et au support ?
- Gouvernance : l’organisation est-elle en mesure d’auditer les actions, de gérer les accès et de respecter ses obligations applicables ?
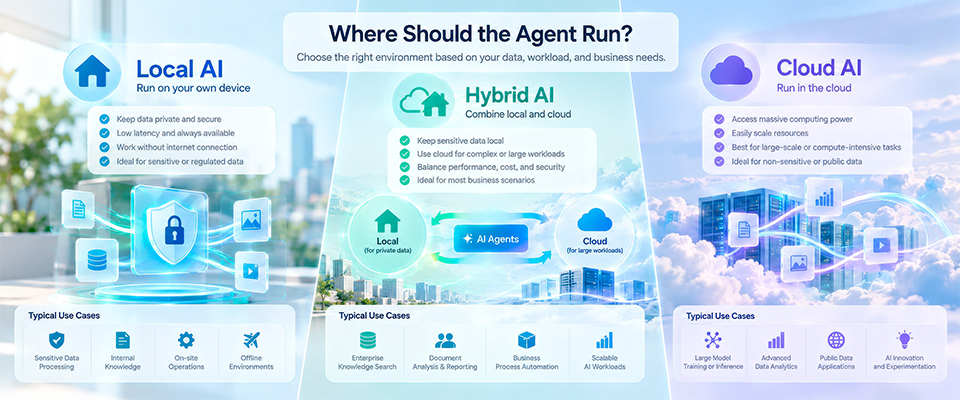
L’architecture de déploiement doit s’appuyer sur une charge de travail éprouvée, et non sur une règle générale imposant que chaque agent doive s’exécuter localement ou dans le cloud.
Conception axée sur la confiance, la sécurité et le contrôle humain
Les autorisations avant l’autonomie
Les agents peuvent être confrontés à du contenu non fiable dans des e-mails, sur des sites web, dans des documents et dans les informations récupérées. Ce contenu peut comporter des instructions trompeuses ou des tentatives visant à détourner un agent de sa mission. Traitez le contenu externe comme des données plutôt que comme une source faisant autorité. Les instructions au niveau du système, les autorisations d’outils et les politiques d’entreprise doivent, dans la mesure du possible, continuer à s’appliquer en dehors du modèle.
Recourez au principe du « droit d’accès minimal ». Séparez les autorisations de lecture, de création de brouillons et d’écriture, exigez une validation pour les actions sensibles et évitez de conférer à un agent polyvalent des identifiants sans restriction. Les actions qui impliquent des dépenses, l’envoi de communications externes, la modification d’enregistrements ou la suppression d’informations méritent des contrôles plus stricts que la synthèse interne.
Une échelle d’autorisation pratique commence par un accès en lecture seule, suivi de la création de brouillons, puis d’actions nécessitant une validation humaine, et seulement ensuite d’une exécution autonome à portée strictement limitée. Chaque étape doit avoir un responsable désigné et des critères d’acceptation. Par exemple, un agent peut rédiger une demande d’achat, mais ne doit pas autoriser le paiement de manière indépendante simplement parce qu’il a accès à une application de gestion des achats.
L’injection de prompts est un autre sujet de préoccupation opérationnelle : des instructions intégrées dans une page web, un document ou un message récupéré peuvent tenter de détourner un agent. Le contenu récupéré doit être traité comme des données plutôt que comme une nouvelle source d’autorité. Limiter les outils, valider les entrées et les sorties, isoler les identifiants et exiger une validation pour les actions ayant des conséquences importantes permettent de réduire l’impact potentiel d’une instruction dangereuse ou erronée.
Rendre les échecs récupérables
Un agent fiable doit savoir quand s’arrêter. Définissez des contrôles de confiance ou de validation, des logiques d’escalade, des limites de dépenses et de temps, ainsi que des procédures de retour en arrière ou de récupération. Consignez les appels aux outils et les décisions importantes en respectant les garanties de confidentialité appropriées. Pour les workflows ayant des conséquences concrètes, recourez à des contrôles déterministes et à une autorisation humaine plutôt que de vous fier uniquement à l’autoévaluation d’un modèle.
La gouvernance ne doit pas être une réflexion après coup ajoutée une fois qu’un projet pilote a abouti. Elle doit être intégrée dès la conception initiale. Le niveau de contrôle doit être proportionnel à l’impact potentiel des actions de l’agent.
Les organisations doivent anticiper que certains résultats fournis par les agents peuvent être incorrects, incomplets, retardés ou dupliqués. Par conséquent, des workflows fiables doivent inclure des délais d’expiration, des nouvelles tentatives limitées, des mesures visant à empêcher les actions en double, ainsi qu’un processus clair d’intervention humaine. Pour les transactions, la conservation d’un historique des actions prévues et réalisées peut aider les équipes à décider s’il faut réessayer, annuler ou résoudre manuellement une opération.
La journalisation (ou logging) doit recueillir suffisamment de preuves pour enquêter sur les échecs tout en évitant toute exposition inutile de contenus confidentiels. Les enregistrements importants doivent inclure la version du flux de travail, les sources de connaissances approuvées, les appels d’outils, les décisions d’autorisation, les catégories d’exceptions et les résultats finaux. Des revues régulières peuvent aider à identifier des schémas qu’une simple démonstration réussie pourrait négliger.
Du projet pilote aux opérations quotidiennes
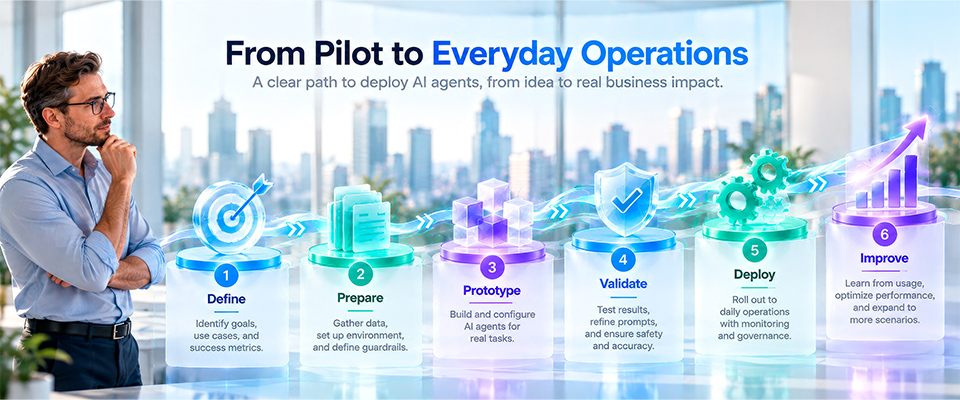
Une feuille de route de déploiement en six étapes
- Définir : sélectionner un workflow, un responsable, un résultat cible et un périmètre opérationnel.
- Préparer : passer en revue les sources de connaissances, les autorisations d’accès aux données, l’accès aux outils et les besoins en infrastructure.
- Prototyper : commencer par un assistant ou un agent aux capacités limitées et des cas de test représentatifs.
- Valider : comparer les résultats à la référence, en tenant compte des échecs et des corrections humaines.
- Déployer : mettre en place un accès limité à l’environnement de production, des points de contrôle d’approbation, la journalisation et l’assistance.
- Améliorer : examiner les résultats, actualiser les connaissances, ajuster les modèles et les autorisations, et n’étendre le déploiement que lorsque cela se justifie.
Cette séquence peut être appliquée aussi bien par un professionnel travaillant seul et utilisant un petit ensemble d’outils approuvés que par une équipe informatique intégrant plusieurs systèmes internes. Bien que la complexité de l’infrastructure puisse varier, les exigences fondamentales en matière de responsabilité, de résultats mesurables et d’accès contrôlé restent constantes.
Au cours de la phase de préparation, créez un ensemble d’évaluation restreint mais représentatif comprenant des demandes typiques, des demandes ambiguës, des documents obsolètes, des informations incomplètes et des tentatives délibérées de dépasser les autorisations. Avant le lancement, convenez de seuils minimaux pour la qualité des réponses, le taux de réussite, le coût acceptable et les logiques d’escalade. Cela garantit que la décision d’étendre le projet pilote repose sur des preuves plutôt que sur une démonstration soignée.
Le déploiement doit se faire par étapes. Commencez par un groupe d’utilisateurs restreint, surveillez l’utilisation réelle et recueillez à la fois les exemples de réussite et d’échec. Attribuez les responsabilités relatives à la gestion des sources de connaissances, à la révision des droits d’accès, à la mise à jour des prompts ou de la logique des workflows, ainsi qu’à la gestion des incidents. Le projet pilote devient pleinement opérationnel lorsque ces responsabilités s’étendent au-delà de l’équipe de projet initiale.
Mesurer ce qui compte après le lancement
Un projet pilote ne doit pas se limiter à la simple réalisation des tâches. Il est important de suivre les résultats globaux positifs, le taux d’intervention humaine, la gravité des erreurs, le temps nécessaire à la réalisation des tâches, le volume de retouches, les coûts d’exploitation par workflow achevé et l’impact global sur les utilisateurs ou les clients. De plus, surveillez les exceptions et tout écart au fil du temps. Un processus plus rapide qui entraîne davantage de corrections en aval peut ne pas offrir un retour sur investissement positif.
Utilisez une comparaison simple : workflow de référence → workflow optimisé par l’IA → résultat vérifié → valeur commerciale. Cela relie directement les décisions de déploiement de l’article n°004 à l’approche de mesure présentée dans l’article n°003.
Un tableau de bord équilibré doit inclure à la fois des indicateurs de résultats et des indicateurs opérationnels. Les indicateurs de résultats peuvent porter sur les délais d’exécution, la capacité de service, la réduction des erreurs, l’expérience client ou les conversions liées au chiffre d’affaires. Les indicateurs opérationnels peuvent inclure les taux d’achèvement des tâches, le pourcentage de cas nécessitant une intervention humaine, les défaillances des outils, l’utilisation des modèles et le coût par workflow mené à bien.
Lors de l’évaluation des résultats, comparez-les à la situation de référence antérieure au déploiement et veillez à faire la distinction entre les exécutions assistées et celles entièrement autonomes. Un taux d’automatisation plus élevé n’est pas nécessairement synonyme de réussite s’il entraîne une augmentation des corrections ou des risques. De même, un système qui transmet fréquemment les dossiers difficiles à un niveau supérieur peut tout de même apporter une valeur ajoutée significative en traitant avec précision les demandes courantes et en permettant aux employés de se concentrer sur des tâches plus complexes.
Scénarios métier pour toutes les tailles d’entreprises
TPE et professionnels indépendants
Un consultant ou un créateur indépendant peut utiliser un agent pour organiser des documents de référence, préparer le suivi de réunions ou rédiger des propositions initiales. Les principaux avantages de cette approche sont la cohérence et le gain de temps. Cependant, certains risques sont également à prendre en compte, tels que des contenus erronés, une divulgation accidentelle et un effort de configuration excessif. Un workflow restreint, basé sur des validations, constitue généralement le meilleur choix dans ce scénario.
Petites et moyennes entreprises
Une PME peut utiliser un agent IA pour comparer les documents des fournisseurs, trier les demandes entrantes, surveiller les rapports d’inventaire approuvés ou rédiger des récapitulatifs de ventes récurrents. Une base de connaissances partagée et quelques connexions bien définies avec des outils peuvent améliorer la coordination sans nécessiter une importante équipe dédiée aux opérations d’IA. La maîtrise des données sources et du processus est essentielle.
Pour une PME, un exemple concret en plusieurs étapes pourrait consister à relier la documentation produit, les demandes des clients et un système de gestion de la relation client. Un agent peut classer les demandes par catégorie, récupérer les réponses approuvées, préparer une proposition de réponse et créer une tâche de suivi. Un commercial approuve tout engagement commercial. Cette approche permet de réduire les tâches de coordination répétitives sans que l’entreprise ait à développer une vaste plateforme d’IA sur mesure.
Une architecture multiagents ne s’avère utile que lorsque des rôles ou des outils distincts justifient une coordination supplémentaire. Un agent peut se spécialiser dans la recherche de documents, un autre dans la préparation de comparaisons structurées, tandis qu’un composant de supervision peut vérifier que les étapes requises ont bien été effectuées. Cependant, un nombre accru d’agents entraîne une latence supplémentaire, des coûts accrus, des contraintes d’autorisation et des modes de défaillance supplémentaires. Un agent unique bien conçu, doté d’outils clairement définis, constitue souvent la meilleure solution pour un premier déploiement.
Grandes organisations
Pour les organisations comportant plusieurs services, la coordination d’agents entre les workflows des services, des opérations, du marketing ou de l’informatique peut s’avérer avantageuse. Cependant, cette configuration pose des défis tels que la gestion des identités, les limites des données, l’auditabilité, l’intégration avec les systèmes existants et la gestion du changement. La coordination multiagents ne doit être mise en place que lorsque la spécialisation des agents améliore de manière démontrable les résultats et non pas simplement parce que l’architecture le permet.
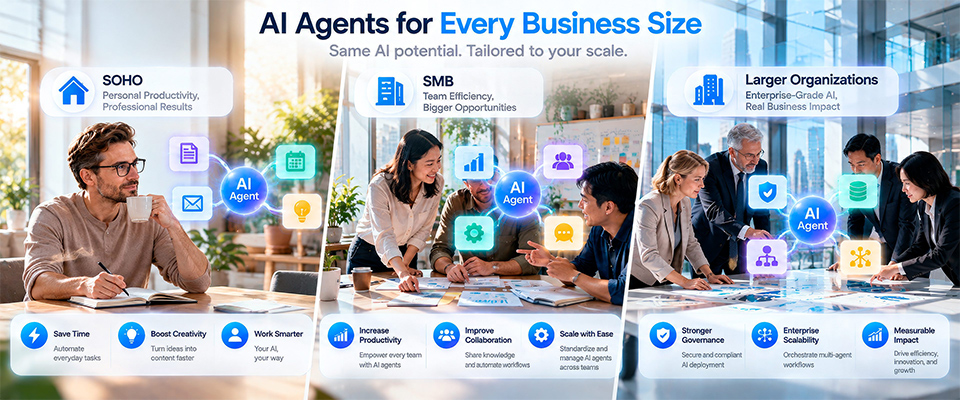
Dans les trois segments, le principe central reste le même : la conception de l’agent doit être guidée par le résultat métier souhaité, et non l’inverse.
Perspectives d’avenir
Des expériences d’IA à une capacité métier fiable
La prochaine étape de l’adoption de l’IA agentique ne se définira pas uniquement par des modèles plus performants ou des démonstrations plus autonomes. Elle se définira par des workflows reproductibles que les personnes peuvent comprendre, superviser et auxquels elles peuvent faire confiance. Les entreprises qui mettront en place cette discipline dès le début seront mieux placées pour évaluer de nouveaux modèles et outils sans devoir constamment redémarrer leur stratégie d’IA.
La progression décrite dans le dossier « MSI – Regard sur l’IA » est désormais claire : comprendre pourquoi les agents sont importants, comprendre où s’exécutent les charges de travail, comprendre comment la valeur est mesurée et mettre en œuvre les bons agents IA avec des contrôles appropriés.
L’objectif n’est pas de déployer le plus grand nombre d’agents IA possible. Il s’agit de développer la capacité à améliorer le travail réel, de manière sûre, mesurable et durable.
Franchissez une nouvelle étape vers l’IA hybride avec MSI PRO MAX EDGE AI+, et restez à l’écoute pour le prochain MSI EdgeMesa N AI+.
Questions clés pour les dirigeants d’entreprise
Q1. Quelle est la différence entre un assistant IA et un agent IA ?
La différence fondamentale réside dans l'autonomie et la capacité d'action : l'assistant IA réagit sur commande pour aider un utilisateur à penser ou rédiger, tandis que l'agent IA agit de manière autonome pour accomplir une mission de bout en bout en utilisant des outils externes.
Q2. Une entreprise a-t-elle besoin de son propre modèle d’IA pour déployer un agent IA ?
Non. De nombreux déploiements utilisent un modèle existant, qu’il soit local ou hébergé. L’essentiel consiste à définir le workflow, à relier les informations et les outils autorisés, et à valider les résultats.
Q3. Qu’est-ce que le RAG, et dans quels cas est-il utile ?
La génération augmentée par récupération (RAG) intègre du contenu pertinent provenant de sources de connaissances approuvées dans le contexte d’un modèle. Elle est utile lorsque les réponses doivent refléter des documents d’entreprise actuels, mais que la qualité des sources et les contrôles d’accès restent essentiels.
Q4. Qu’est-ce que l’appel d’outils ?
L’appel d’outils permet à un agent de solliciter une fonction autorisée d’une application, telle que la recherche dans un catalogue ou la création d’un brouillon. L’application doit appliquer de manière indépendante les autorisations et valider les données d’entrée.
Q5. Un système multiagent est-il nécessaire ?
Généralement pas pour un premier projet pilote. Plusieurs agents spécialisés peuvent faciliter les workflows complexes, mais ils impliquent des exigences supplémentaires en matière de coordination et de surveillance. Commencez par l’architecture la plus simple qui fonctionne.
Q6. Les agents IA doivent-ils s’exécuter localement ou dans le cloud ?
Faites votre choix en fonction de la sensibilité des données, des capacités du modèle, du coût, de la disponibilité, de la latence et de la capacité opérationnelle. Certaines charges de travail tirent parti d’une exécution hybride, il n’y a pas de réponse universelle.
Q7. Un agent local peut-il fonctionner sans Internet ?
Certains modèles et outils locaux peuvent fonctionner hors ligne, à condition que toutes les données et tous les services requis soient disponibles localement. Les outils dépendants du cloud, les mises à jour et les intégrations externes nécessitent toutefois une connexion Internet.
Q8. Comment les organisations peuvent-elles réduire les risques liés aux agents ?
Utilisez le principe du « privilège minimal », des sources de connaissances fiables, des points de contrôle d’approbation, la validation, la journalisation, des limites sur les actions et une procédure claire de remontée vers les humains.
Q9. Comment évaluer un projet pilote d’agent IA ?
Comparez les workflows de référence et ceux optimisés par l’IA en fonction de la qualité des résultats, du temps d’exécution, du taux d’intervention, des erreurs, des retouches, du coût et de l’impact sur l’activité, et pas seulement les prompts ou les benchmarks des modèles.
Q10. Par où une petite entreprise doit-elle commencer ?
Sélectionnez un workflow récurrent, à faible risque et dont la valeur est mesurable. Commencez par des actions en lecture seule ou des brouillons, testez-les sur des cas réels et n’élargissez l’accès qu’une fois que les résultats sont fiables.
Poursuivez le parcours « MSI - Regards sur l’IA »
Numéro précédent
« MSI - Regards sur l’IA » - Article n° 003 | Au-delà de la productivité : mesurer la véritable valeur commerciale de l’IA agentique
Découvrez pourquoi le gain de temps n’est qu’un début, et comment la rentabilité des workflows, les résultats commerciaux et la valeur humaine contribuent à renforcer le business case de l’IA.
https://fr.msi.com/blog/ai-insights-beyond-productivity-of-agentic-ai
« MSI - Regards sur l’IA » - Article n° 002 | L’entreprise hybride en matière d’IA : construire une IA d’entreprise autour du travail, et non de l’infrastructure
https://fr.msi.com/blog/the-hybrid-ai-enterprise
Découvrez pourquoi le placement des charges de travail de l’IA doit refléter les besoins métier plutôt qu’un modèle d’infrastructure unique.
« MSI - Regards sur l’IA » - Article n° 001 | L’essor de l’IA agentique
Comprenez la transition des assistants basés sur des prompts vers des agents IA capables de participer à des tâches en plusieurs étapes.
https://fr.msi.com/blog/the-rise-of-agentic-ai
Numéro actuel
« MSI - Regards sur l’IA » - Article n° 004 | Travailler avec les agents IA
Un cadre pratique pour transformer la stratégie d’IA agentique en un déploiement métier concret.
Références
- NIST - Cadre de gestion des risques liés à l’intelligence artificielle (AI RMF 1.0)
https://doi.org/10.6028/NIST.AI.100-1 - NIST - Profil d’intelligence artificielle générative de l’AI RMF
https://doi.org/10.6028/NIST.AI.600-1 - OWASP - Top 10 des applications utilisant des grands modèles de langage
https://genai.owasp.org/llm-top-10/ - MITRE - ATLAS : panorama des menaces adversaires pour les systèmes d’intelligence artificielle
https://atlas.mitre.org/ - Microsoft - Indice des tendances du travail 2025
https://www.microsoft.com/en-us/worklab/work-trend-index/2025-the-year-the-frontier-firm-is-born - McKinsey - L’état de l’IA
https://www.mckinsey.com/capabilities/quantumblack/our-insights/the-state-of-ai - Institut pour l'intelligence artificielle centrée sur l'humain de l'université de Stanford (HAI) -Rapport sur l’indice de l’IA 2026
https://hai.stanford.edu/ai-index/2026-ai-index-report
Lectures complémentaires
- NIST - Centre de ressources sur l’IA
https://airc.nist.gov/ - OCDE - IA et travail
https://www.oecd.org/en/topics/ai-and-work.html - Anthropic - Indice économique
https://www.anthropic.com/economic-index - NVIDIA - Plans d’action pour l’IA
https://www.nvidia.com/en-us/ai/
À propos de « MSI - Regards sur l’IA »
« MSI - Regards sur l’IA » est une série éditoriale qui explore la manière dont l’intelligence artificielle redéfinit l’informatique, le travail et la stratégie d’entreprise.
Chaque numéro examine une question cruciale soulevée par l’évolution de l’IA, de l’IA générative et de l’IA agentique à l’IA hybride, en passant par le déploiement en entreprise, la valeur commerciale et l’avenir de l’informatique intelligente.
Plutôt que de se concentrer uniquement sur la technologie ou les performances des modèles, « MSI - Regards sur l’IA » relie les capacités de l’IA aux enjeux commerciaux concrets, aidant ainsi les responsables technologiques, les décideurs, les développeurs et les organisations à comprendre ce qui change, pourquoi c’est important et comment se préparer à l’avenir.
À propos de MSI
Micro-Star INT'L CO., LTD. (MSI) est une entreprise technologique mondiale dont l’expertise couvre le matériel informatique, les PC dotés d’IA, les solutions de Business and Productivity, le jeu vidéo, la création de contenu et l’informatique d’entreprise.
Alors que l’intelligence artificielle s’intègre de plus en plus dans l’informatique quotidienne, MSI continue d’explorer comment les avancées en matière d’architecture informatique, d’accélération de l’IA, d’écosystèmes logiciels et d’applications intelligentes peuvent ouvrir la voie à de nouvelles façons de travailler, de créer et de fonctionner.
Grâce à ses produits, à ses partenariats technologiques et à ses initiatives en cours dans le domaine de l’IA, MSI vise à rendre les technologies informatiques de pointe plus accessibles et plus pratiques pour un large éventail d’utilisateurs et de secteurs d’activité.
À propos de cette publication
Publication : « MSI - Regards sur l’IA » - Article n° 004
Titre : Travailler avec les agents IA : un cadre pratique pour le déploiement de l’IA en entreprise
Date de publication : octobre 2026
Éditeur : Micro-Star International Co., Ltd.
Langue : Français (traduit de l’anglais)
Avertissement
Cette publication est destinée uniquement à des fins d’information et de formation.
Les points de vue présentés s’appuient sur des recherches accessibles au public, les tendances du secteur et l’analyse des auteurs au moment de la publication.
Les technologies d’intelligence artificielle continuent d’évoluer rapidement. Les lecteurs sont invités à consulter la documentation officielle la plus récente ainsi que les recommandations du secteur avant de prendre des décisions technologiques ou commerciales.
Les noms de sociétés tierces, les marques déposées, les produits et les technologies mentionnés dans le présent document restent la propriété de leurs détenteurs respectifs.
Copyright
© 2026 Micro-Star International Co., Ltd. Tous droits réservés.
Aucune partie de cette publication ne peut être reproduite, distribuée, transmise ou stockée sous quelque forme que ce soit sans l’autorisation écrite préalable de Micro-Star International Co., Ltd., à l’exception de brèves citations utilisées à des fins de critique, de recherche ou d’enseignement, accompagnées d’une mention appropriée de la source.